A software engineer troubleshooting an API integration at a desk with code, notes, and a monitor. AI-generated editorial image.
Si votre MVP dépend d’API tierces, le vrai défi n’est pas seulement d’envoyer une requête. Il faut aussi rendre l’intégration assez fiable pour que le produit continue de fonctionner lorsque l’authentification change, que le format des données évolue ou qu’un fournisseur renvoie une réponse inattendue. Le moyen le plus rapide de réduire le risque consiste à déboguer l’intégration de manière systématique, à choisir l’approche la plus simple adaptée au produit, puis à vérifier tout le flux avec des cas de test réalistes.
Cet article traite d’un problème d’ingénierie concret : comment diagnostiquer les intégrations API afin de déterminer si le souci vient de votre code, de vos données ou du service externe. La même méthode aide aussi à décider s’il vaut mieux appeler l’API directement côté client, passer par le backend ou l’isoler derrière une couche d’intégration.
Commencez par le symptôme, pas par la pile technique
Les échecs d’API se ressemblent souvent au départ : délai d’attente, réponse 4xx, réponse 5xx, données manquantes ou réponse qui ne correspond pas à ce que l’interface attend. Avant de modifier le code, limitez le problème à l’un de ces trois domaines :
- Construction de la requête : en-têtes, paramètres de requête, corps, jeton d’authentification et méthode HTTP.
- Comportement du fournisseur : limites de débit, règles de validation, différences d’environnement ou pannes temporaires.
- Votre traitement interne : analyse, mappage, relances, transformation des erreurs ou gestion d’état.
Un bon réflexe consiste à reproduire la requête exacte en dehors de votre application. Si elle échoue aussi dans un outil isolé ou un script, le problème ne se limite probablement pas à votre code d’interface. Si elle fonctionne, le bug se trouve souvent dans le flux applicatif, la sérialisation ou la configuration.
Choisissez une forme d’intégration adaptée au produit
Il n’existe pas d’approche unique pour tous les MVP. Le bon choix dépend de la sécurité, de la latence, de la maintenabilité et du niveau de contrôle nécessaire sur le contrat externe.
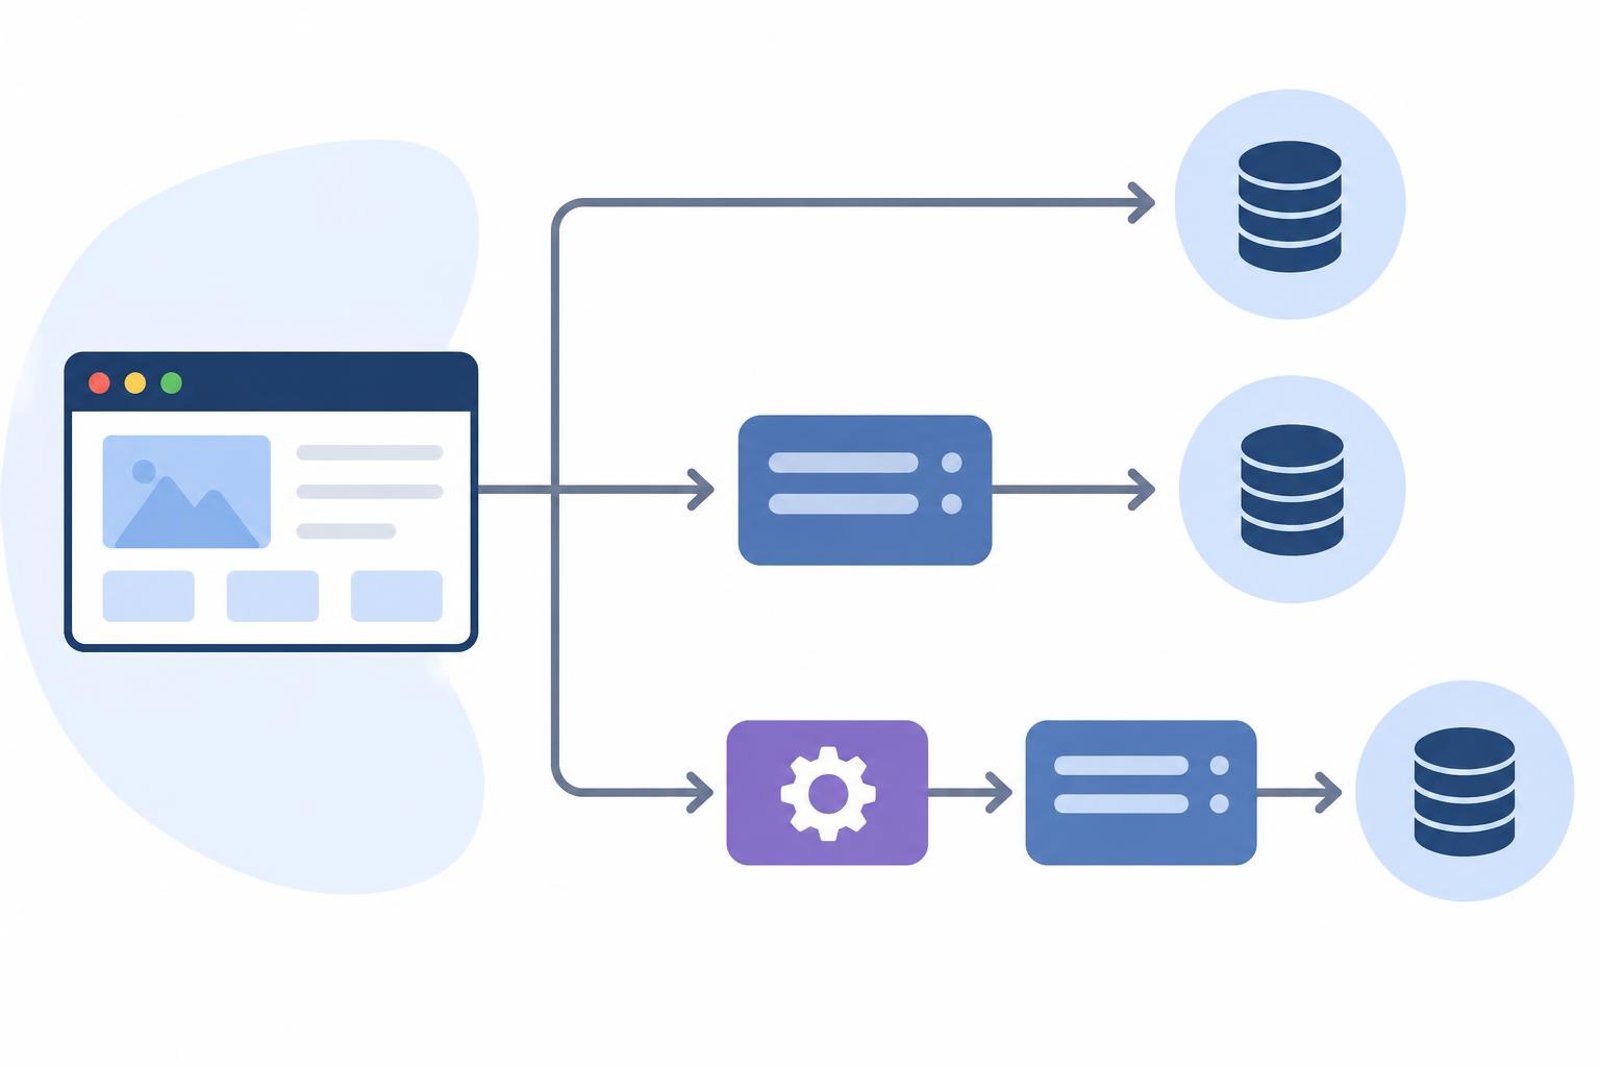
Appels directs côté client
Cela peut convenir à des API publiques, peu risquées et ne nécessitant pas de secret. L’avantage principal est la simplicité. Les inconvénients sont une maîtrise plus limitée des relances, une gestion des erreurs moins homogène et un risque plus élevé d’exposer une logique sensible dans le navigateur ou le client mobile.
Appels médiés par le backend
Pour beaucoup de produits en démarrage, une route backend est le choix le plus sûr par défaut. Elle garde les identifiants hors du client, offre un endroit stable pour normaliser les réponses et permet de journaliser, relancer, mettre en cache ou transformer les requêtes de façon cohérente. Elle facilite aussi les évolutions futures si l’API du fournisseur change.
Couche d’intégration dédiée
Lorsque le service externe est central, une petite couche d’adaptation peut être rentable. Elle traduit les formes propres au fournisseur en votre propre modèle de domaine, ce qui réduit le couplage. En contrepartie, cela ajoute du code à maintenir, donc cette approche doit être justifiée par une complexité réelle et non utilisée partout par défaut.
Règle pratique : si l’API tierce est susceptible d’évoluer, isolez tôt que possible sa forme de réponse derrière une interface interne.
Déboguer la requête par étapes
Un flux fiable consiste à aller de l’extérieur vers l’intérieur :
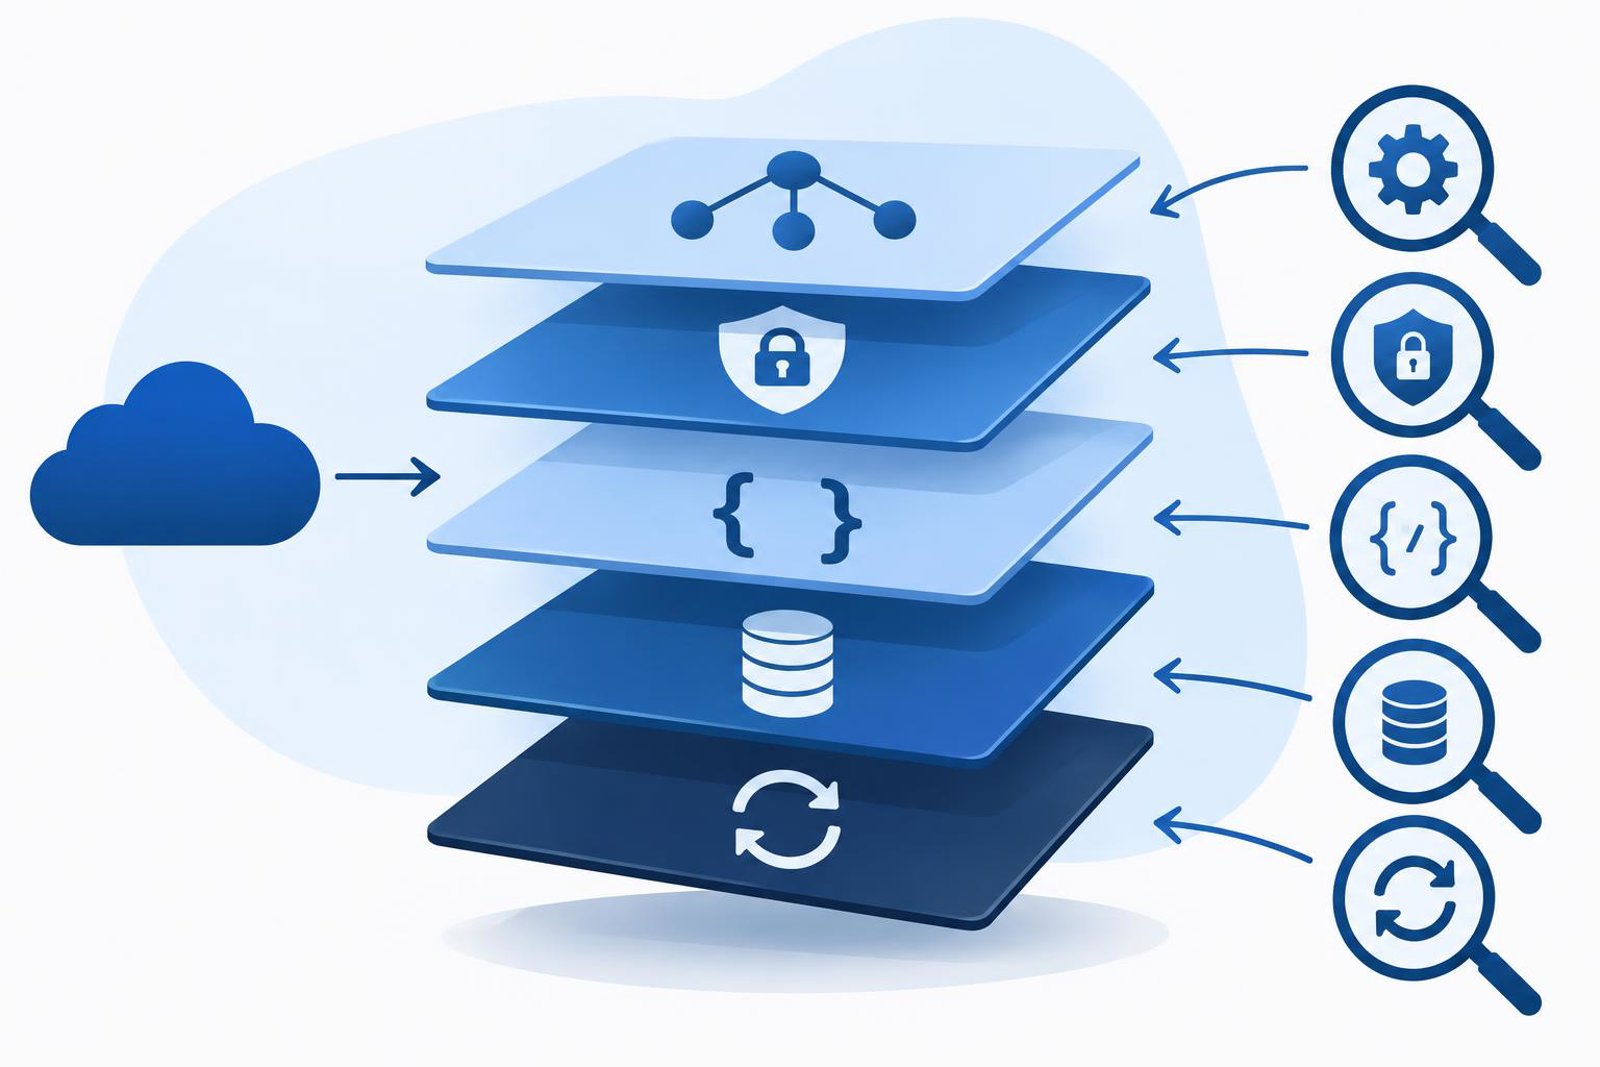
- Confirmer la connectivité : vérifier l’URL, l’environnement et l’accès réseau de base.
- Inspecter l’authentification : vérifier que le jeton, la clé ou la session est valide et envoyé dans le format attendu.
- Comparer les charges utiles : s’assurer que le corps et les en-têtes correspondent exactement aux attentes du fournisseur.
- Vérifier l’analyse de la réponse : contrôler que le code gère bien les formats de succès et d’erreur.
- Revoir les relances et les délais : éviter des relances trop agressives ou des timeouts trop courts.
Une erreur fréquente consiste à supposer que le fournisseur renvoie toujours du JSON dans la même forme. En pratique, les réponses d’erreur peuvent différer des réponses de succès. Votre gestionnaire doit donc être prêt à traiter des champs manquants, des tableaux vides ou des codes de statut différents.
Une autre erreur courante est de considérer toute panne comme relançable. Certaines erreurs sont permanentes, comme une entrée invalide ou une autorisation refusée. Les relancer n’apporte rien et complique le diagnostic.
Un code qui rend les échecs visibles
Un code minimal et lisible révèle souvent plus qu’une abstraction lourde. Par exemple, un petit wrapper peut séparer les erreurs de transport des erreurs applicatives :
async function fetchJson(url, options) {
  const response = await fetch(url, options);

  if (!response.ok) {
    const text = await response.text();
    throw new Error(`Request failed: ${response.status} ${text}`);
  }

  return response.json();
}
Cet exemple est volontairement simple. Dans une vraie application, vous voudrez peut-être ajouter des objets d’erreur structurés, des identifiants de requête et une normalisation propre au fournisseur. L’idée est surtout de rendre l’échec visible avant d’ajouter des couches d’abstraction.
Si vous utilisez une couche d’intégration, gardez une frontière claire. Une partie du code doit connaître les détails du fournisseur, tandis que le reste de l’application doit parler dans vos propres termes. Cette séparation facilite les tests, car vous pouvez remplacer le fournisseur par un stub ou un mock sans réécrire tout le flux produit.
Tester l’intégration comme le produit va l’utiliser
Tester une intégration API ne consiste pas seulement à vérifier le cas nominal. Il faut valider le comportement complet que les utilisateurs vont ressentir.
- Cas de succès : l’API renvoie les données attendues et votre interface ou backend les utilise correctement.
- Échec de validation : une entrée invalide est rejetée proprement et l’utilisateur reçoit un message utile.
- Délai ou panne réseau : votre application se dégrade avec grâce au lieu de se figer ou de planter.
- Structure inattendue : des champs manquants ou supplémentaires ne cassent pas l’application.
- Échec d’autorisation : votre système gère de façon prévisible des identifiants expirés ou absents.
Quand c’est possible, conservez un petit ensemble de fixtures représentant les réponses les plus importantes du fournisseur. Cela permet de détecter les régressions lorsqu’une modification touche la construction des requêtes ou le mappage des réponses.
Pour gagner en confiance, ajoutez un contrôle de bout en bout qui emprunte le même chemin que votre produit en production. Cela ne veut pas dire tester le comportement interne du fournisseur. Cela signifie vérifier que votre propre code sait envoyer, recevoir et gérer correctement l’intégration.
Compromis à évaluer avant le lancement
Chaque décision d’intégration implique des compromis. Une checklist rapide peut aider à décider ce qui compte le plus pour la version actuelle :
- Vitesse contre contrôle : les appels directs sont plus rapides à construire, mais la médiation backend offre davantage de contrôle.
- Simplicité contre robustesse : moins de couches réduit la complexité, mais des wrappers peuvent rendre les échecs plus faciles à gérer.
- Flexibilité contre couplage : exploiter la réponse brute du fournisseur est simple au début, mais un modèle métier est souvent plus facile à maintenir ensuite.
- Observabilité contre surcharge : journaux et métriques aident au débogage, mais seulement s’ils restent ciblés et lisibles.
Pour un MVP, le meilleur choix est souvent celui qui réduit les inconnues plutôt que celui qui paraît le plus élégant. Si l’intégration est critique pour le business, une structure supplémentaire est souvent justifiée. Si elle est périphérique, gardez-la légère.
Checklist simple de vérification
Avant de considérer l’intégration comme terminée, vérifiez les points suivants :
- La requête est reproductible en dehors de l’application.
- Les identifiants sont stockés et transmis de manière sûre.
- Les réponses de succès et d’erreur sont toutes deux gérées.
- Les délais et relances correspondent à l’importance de l’opération.
- L’intégration dispose d’au moins un test couvrant le chemin le plus critique du produit.
- Le reste de l’application ne dépend pas directement de la forme spécifique du fournisseur, sauf choix délibéré.
Si vous pouvez valider ces éléments, vous avez beaucoup plus de chances de livrer une intégration API qui tient en conditions réelles plutôt qu’un simple démonstrateur heureux.
Pour d’autres articles pratiques sur la construction et la maintenance de systèmes logiciels, consultez le blog technique, et pour le contexte plus large du travail d’ingénierie, visitez Urey Mutuale.
Prochaine étape : choisissez une API de votre produit actuel, retracez son flux de requête et de réponse de bout en bout, puis ajoutez un test couvrant un cas d’échec que vous n’avez pas encore validé.